郭奕辰

郭奕辰

人工智能研究

南洋理工大学

寻求博士机会 · 2027 年春季 / 秋季

论文

Google Scholar

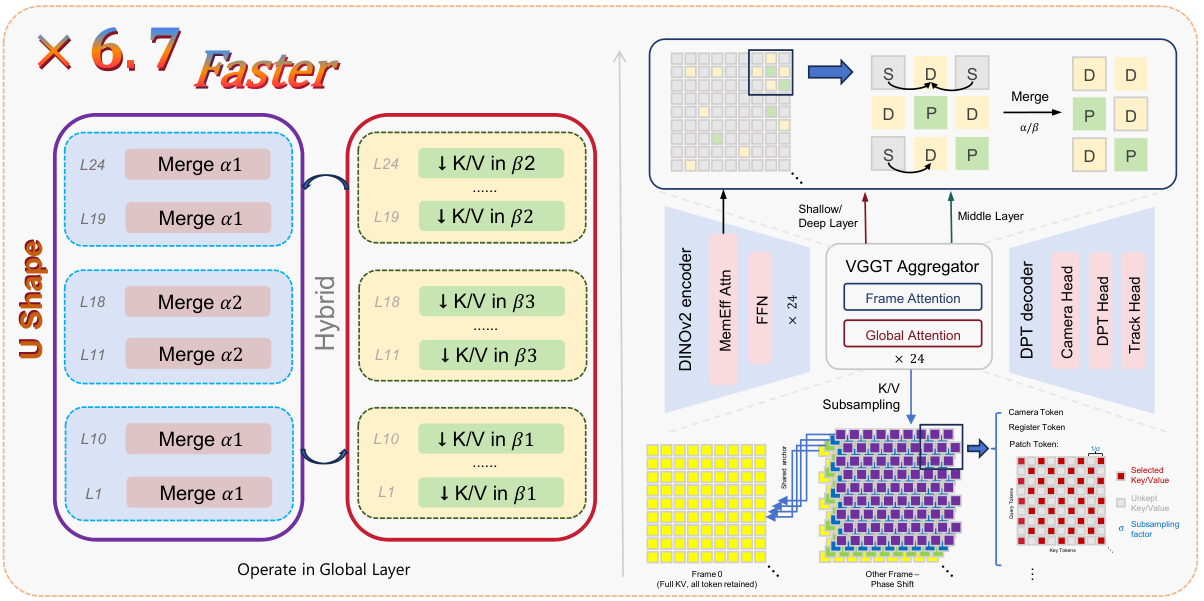
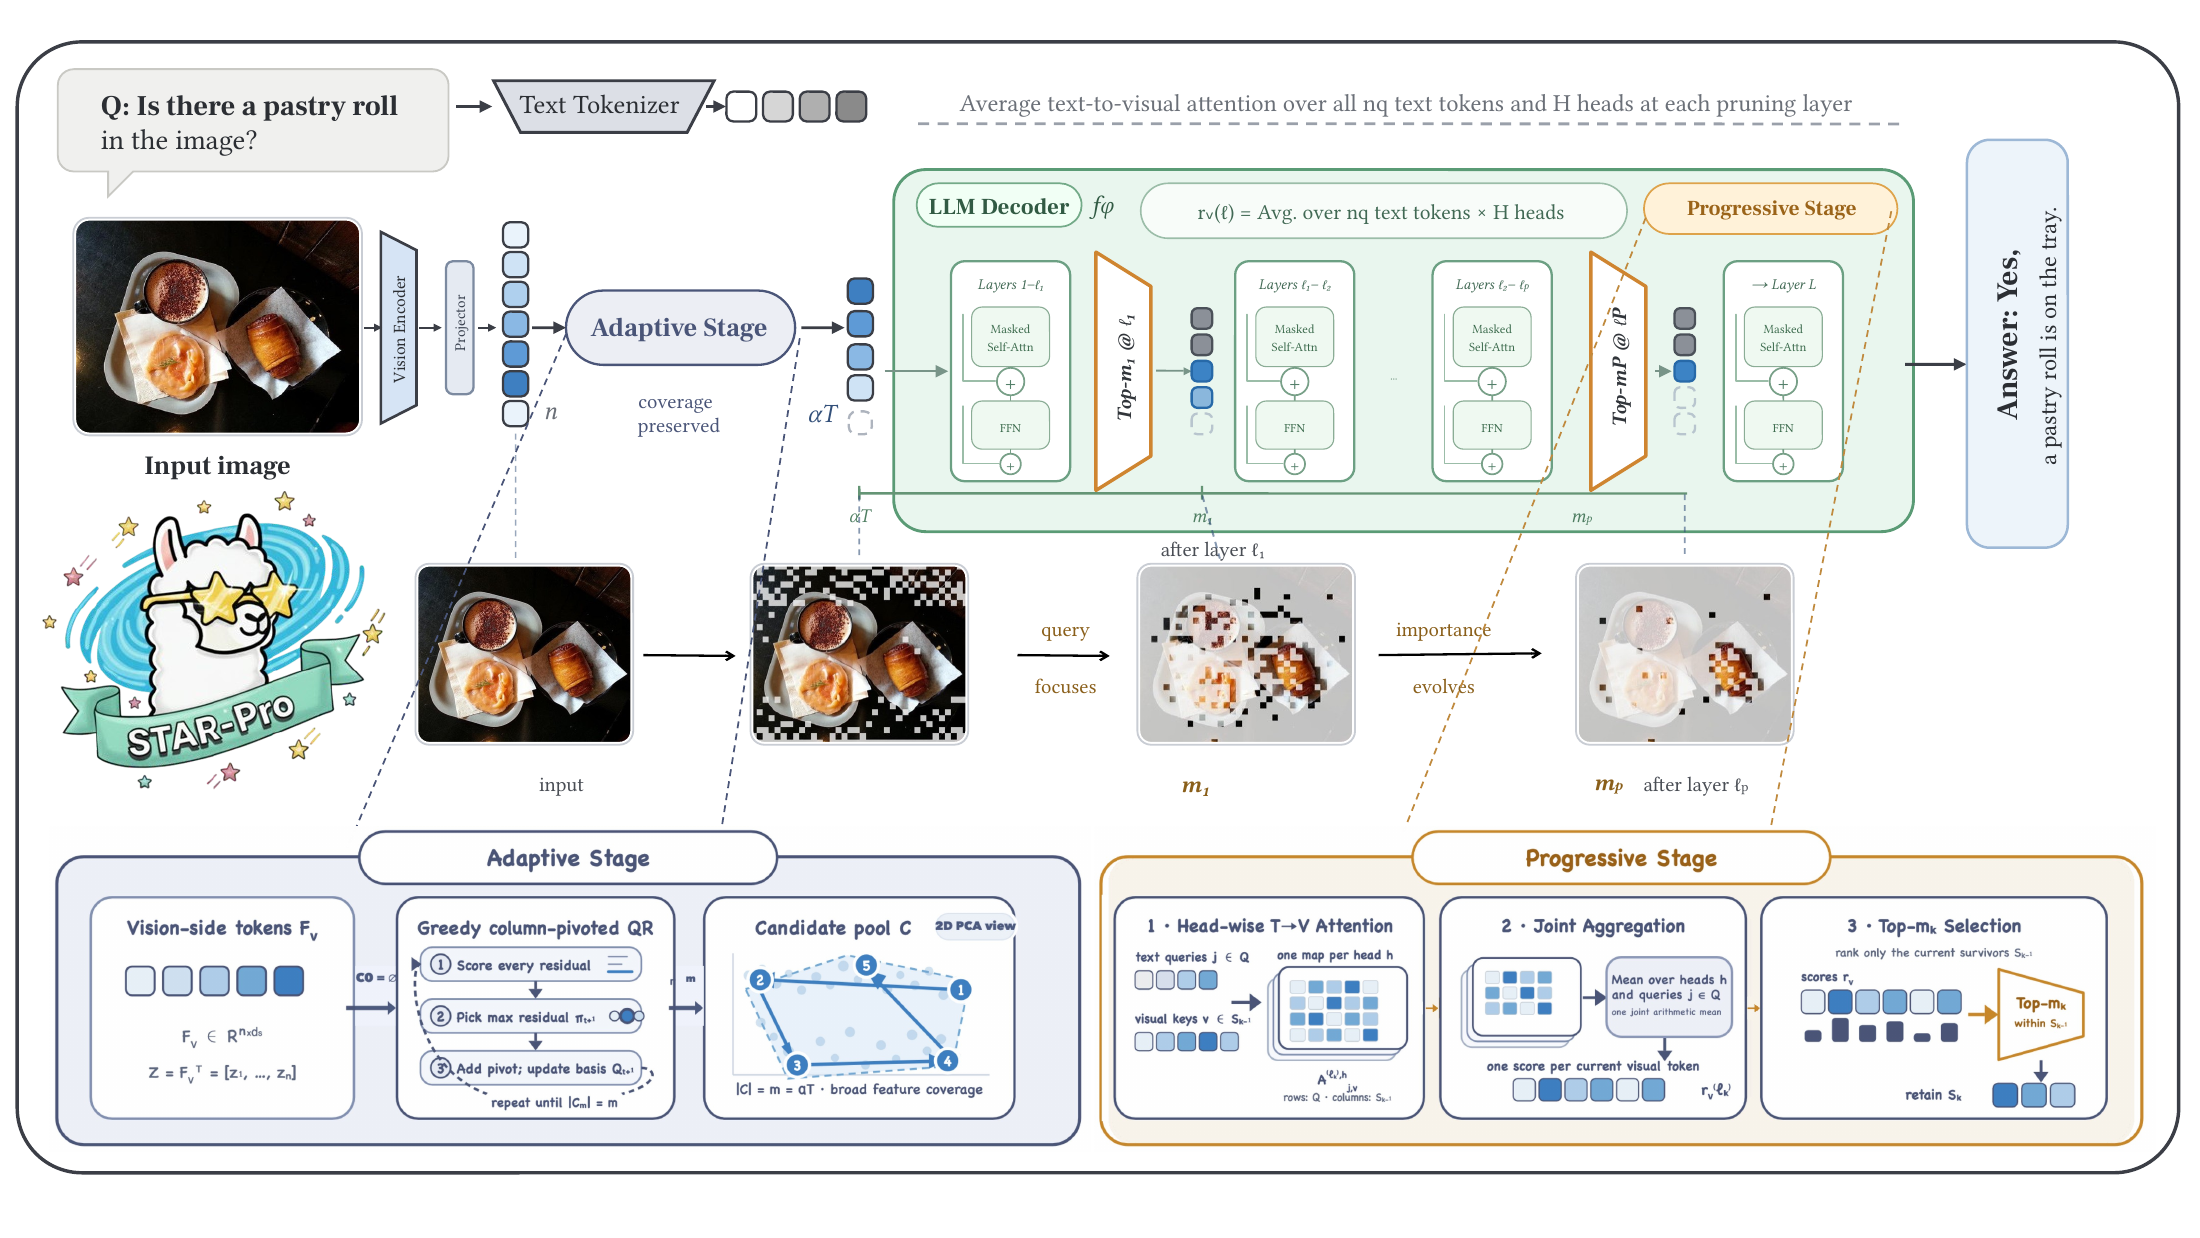
  1. STAR-Pro 先通过自适应阶段保留视觉特征覆盖度,再跨解码器层逐步细化视觉 token。 arXiv

    STAR-Pro: Stage-Wise Token Adaptive Reduction with Progressive Refinement for Efficient Large Vision-Language Models

    Yichen Guo, Tinghao Wang, Qizhe Zhang, Lingbei Meng, Yuan Zhang, Jiajun Cao, Hao Jiang, Chenwei Wu, Jixian Wu, Sixiang Chen, Tao Luo, Hongyang Cheng, Kai Tang, Chenxi Li, Renyuan Li, Xiande Huang, Wenya Wang, Shanghang Zhang

    审稿中 · 2026 · 共同第一作者

    无需训练的视觉 token 压缩:先保留特征覆盖度,再随语言与视觉交互逐步细化保留的 token。

    我的贡献: 作为共同第一作者,我参与了从自适应选择到渐进剪枝的方法设计,以及跨视觉语言模型架构的评测。
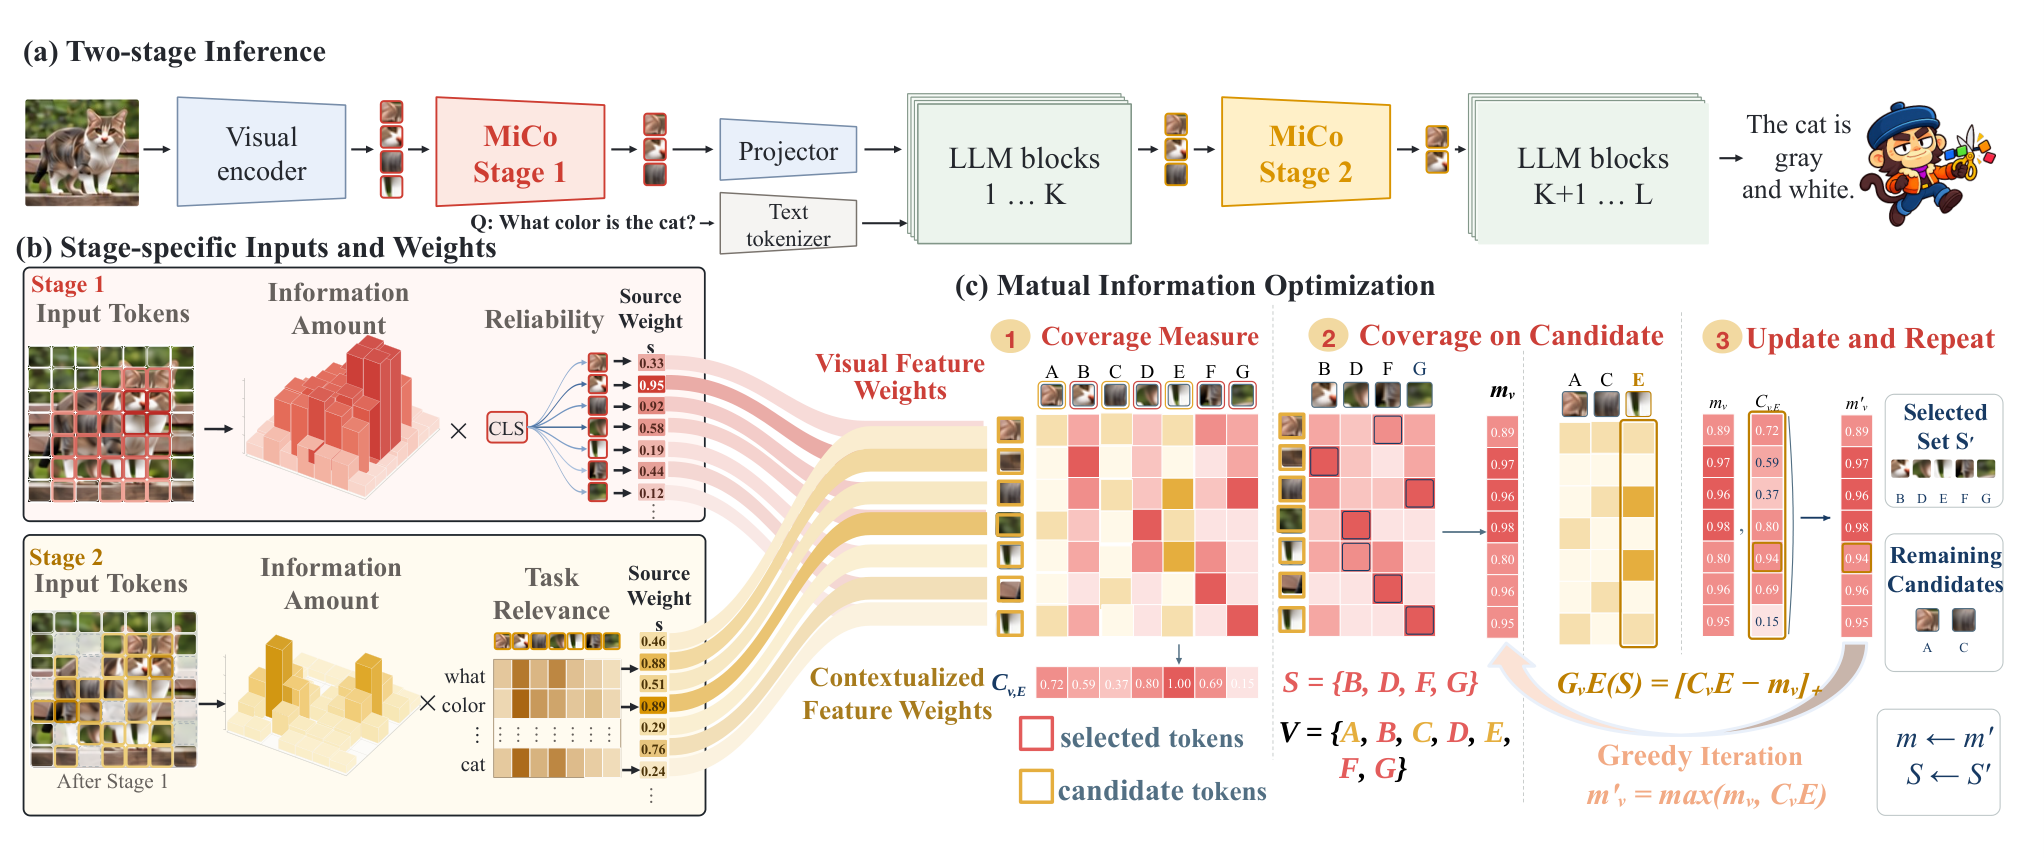
  2. MiCo 两阶段剪枝框架:视觉候选选择、任务相关细化,以及贪心互信息覆盖优化。 arXiv

    MiCo: Mutual Information Coverage Optimization through Semantic Erasure Modeling for Efficient MLLM Inference

    Tinghao Wang, Yichen Guo, Qizhe Zhang, Yuan Zhang, Weimin Ouyang, Rui Huang, Jiajun Cao, Sixiang Chen, Hao Jiang, Jixian Wu, Zheng Lu, Bofan Zhu, Renyuan Li, Shanghang Zhang

    预印本 · 2026 · 共同第一作者

    通过互信息覆盖优化开展无需训练的两阶段视觉 token 剪枝:先选择有代表性的视觉候选池,再利用任务相关信号细化。

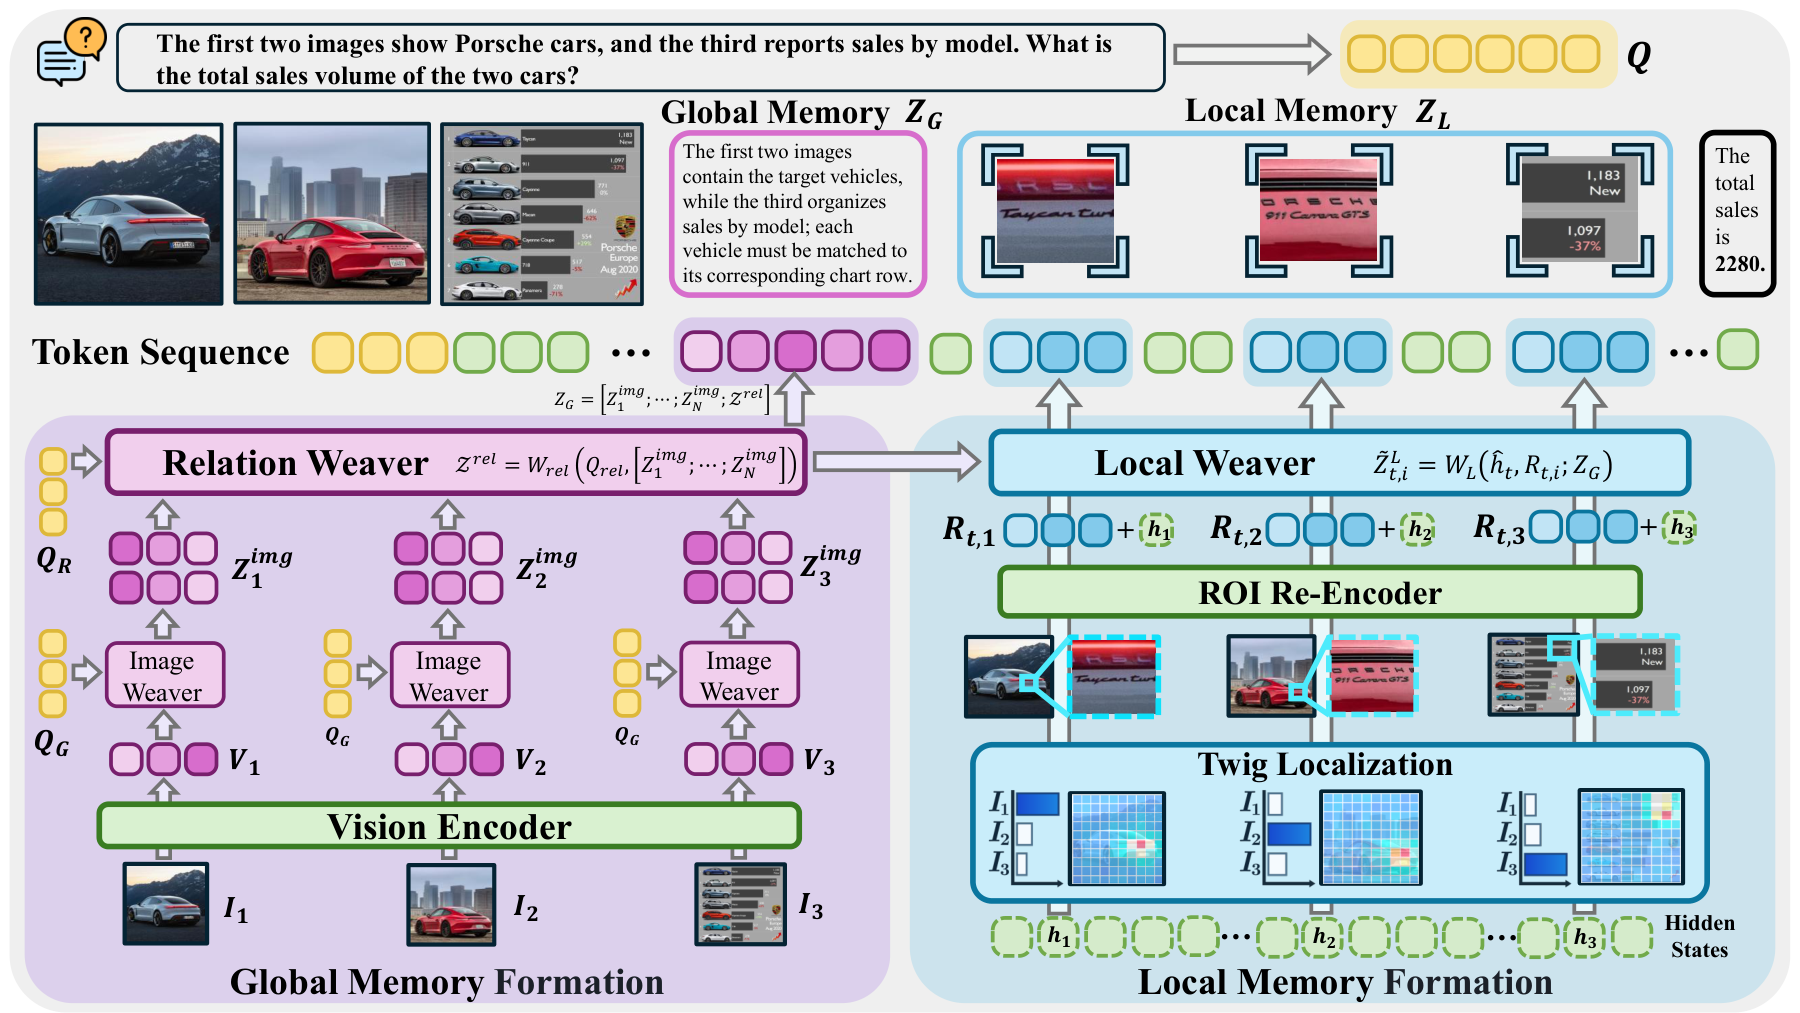
  3. ReMAP 将全局场景上下文、局部区域证据与强化学习记忆访问策略结合,用于多模态推理。 arXiv

    ReMAP: Restoring the Perceptual Cycle with Reasoning-Time Latent Visual Memory

    Hao Jiang*, Zhanyu Guo*, Chenwei Wu†, Yichen Guo†, Qizhe Zhang, Junchi Yao, Jixian Wu, Jinhao You, Kai Tang, Jiajun Cao, Tinghao Wang, Mengyu Wang, Leo Anthony Celi, Shanghang Zhang

    * 共同第一作者 · † 项目负责人

    预印本 · 2026 · 项目负责人(Project Leader)

    通过全局与局部潜在视觉记忆,在推理过程中补充视觉证据;强化学习策略决定何时检索哪类记忆。

    我的贡献: 担任项目负责人,参与潜在视觉记忆与多模态推理中记忆访问策略的研究。

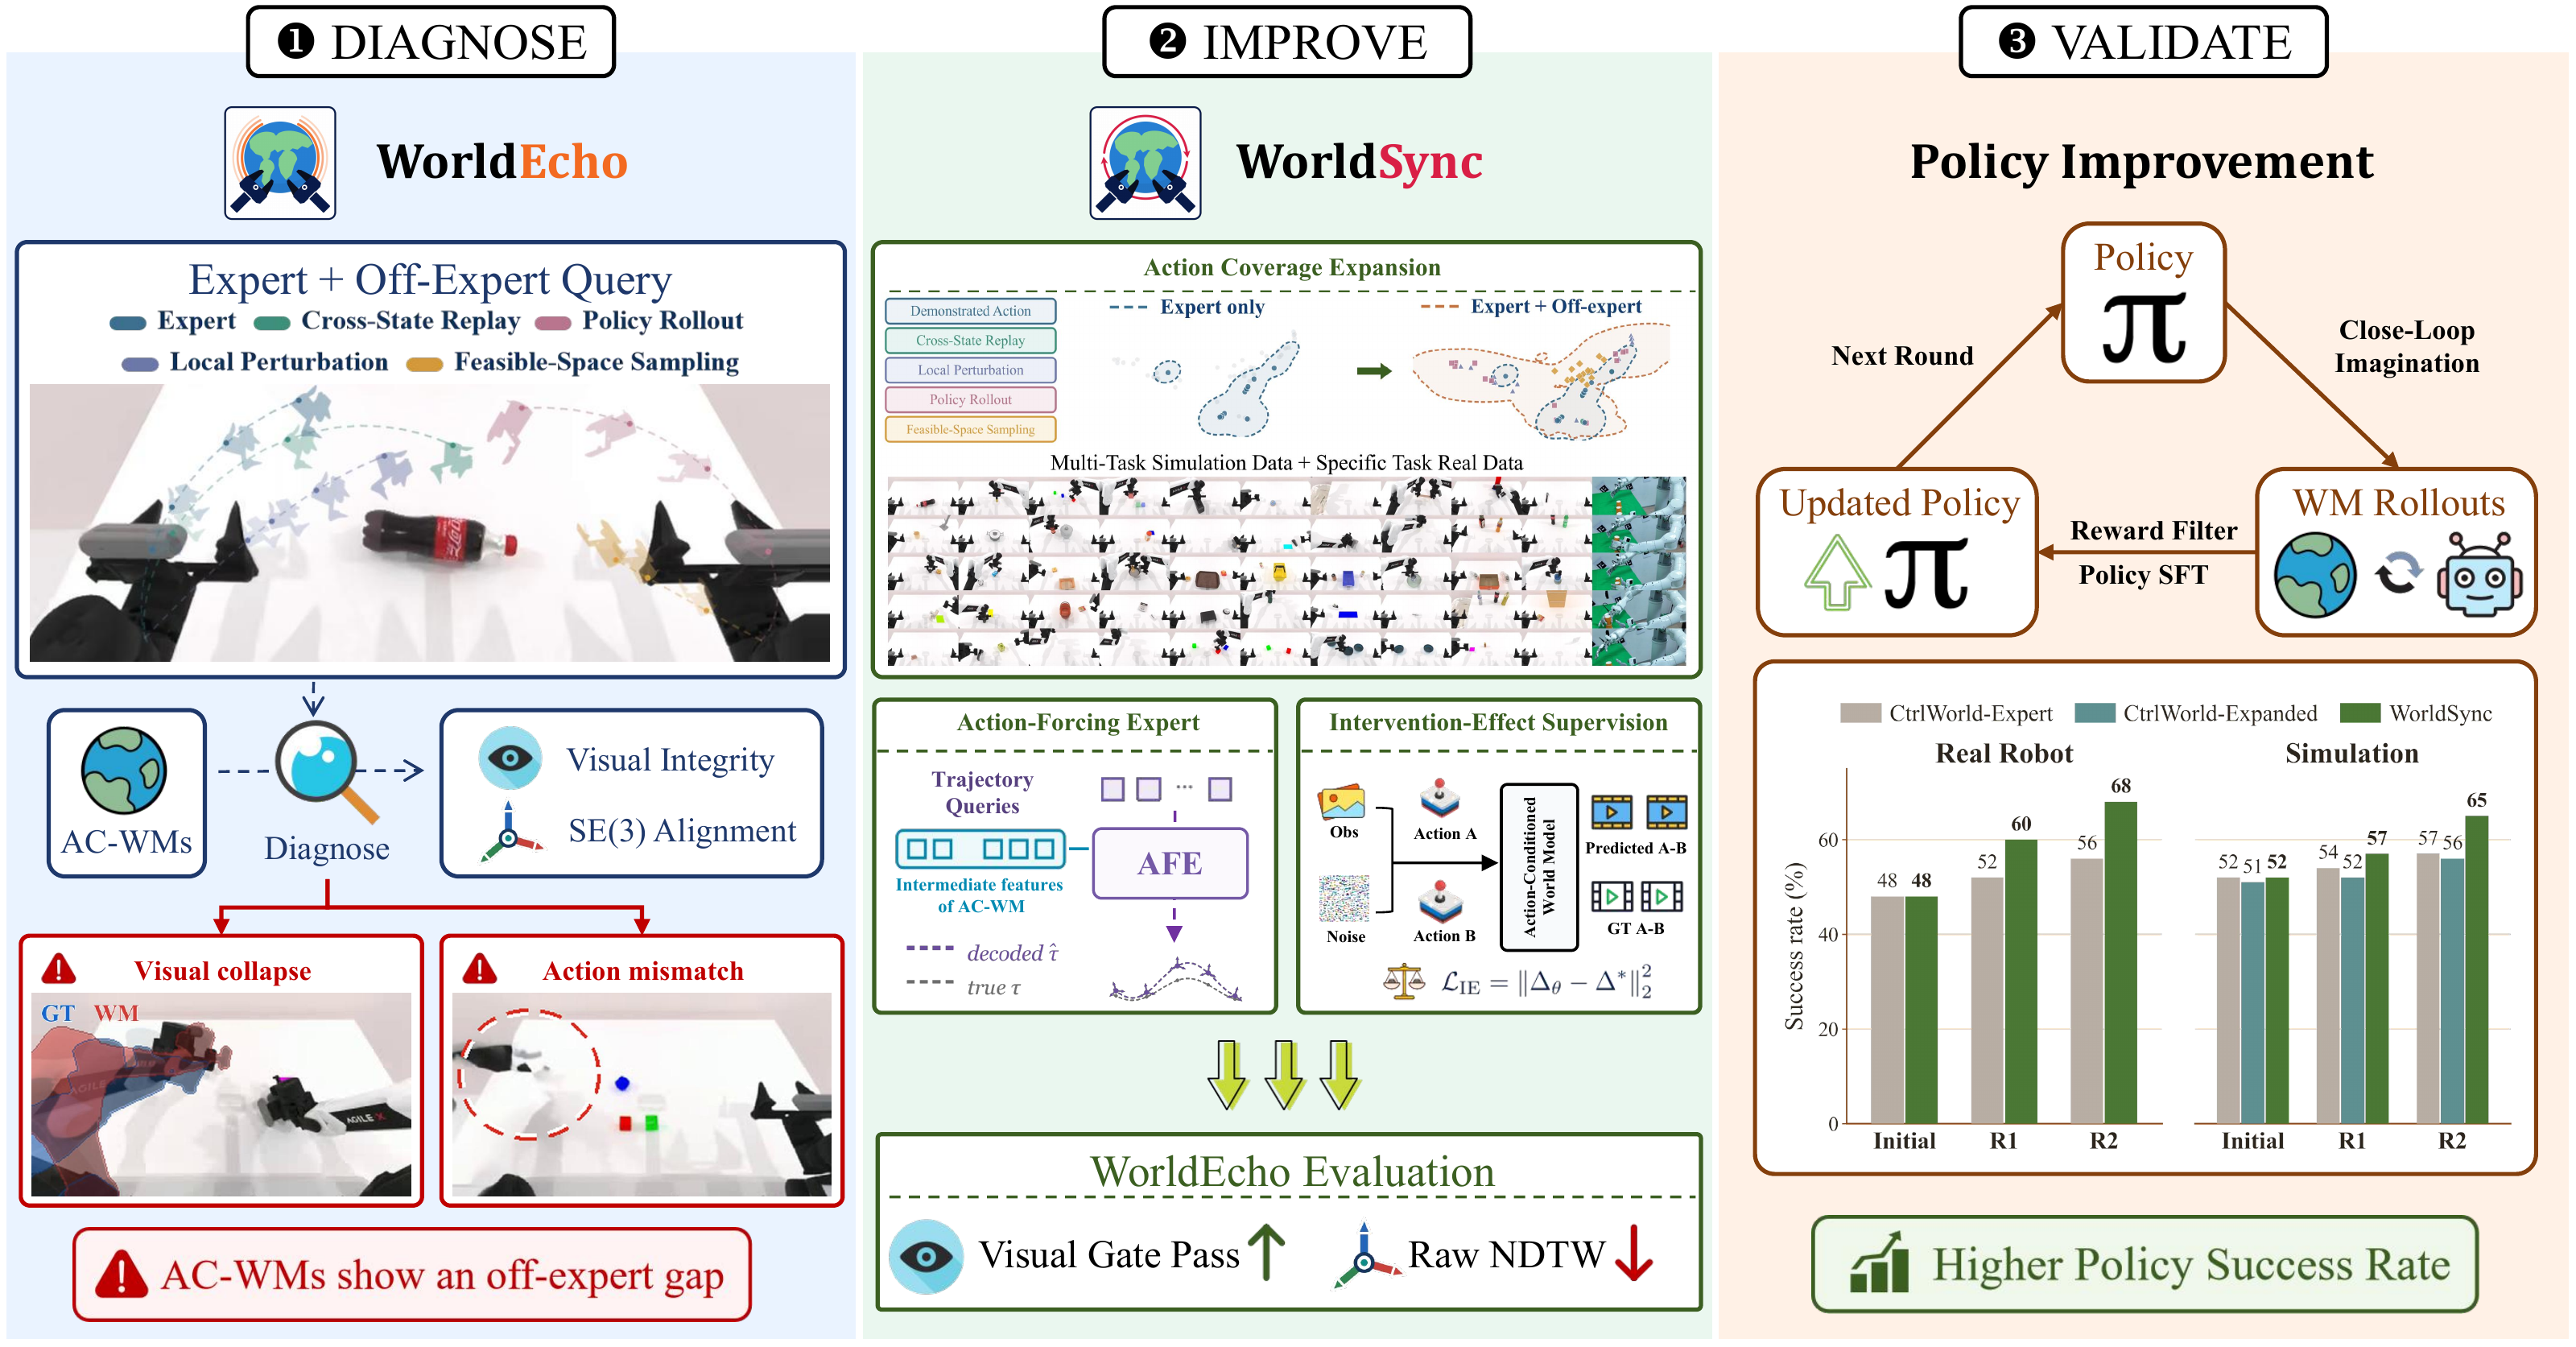
  4. WorldEcho 与 WorldSync 的研究流程:诊断动作遵循、对齐世界模型,并验证策略学习。 arXiv

    Do Robotic World Models Really Follow Actions? Diagnosing and Aligning Action-Conditioned Generation for Policy Learning

    Sixiang Chen, Jiaming Liu, Jixian Wu, Yichen Guo, Tinghao Wang, Siyuan Qian, Hao Chen, Jiajun Cao, Jian Tang, Shanghang Zhang

    预印本 · 2026 · 核心贡献者

    WorldEcho 诊断动作遵循失败;WorldSync 将生成过程与机器人动力学对齐,以支持策略学习。

    我的贡献: 作为核心贡献者,我参与理解并改善机器人世界模型的动作遵循能力。

    数据集目前限制访问,数据尚待上传。

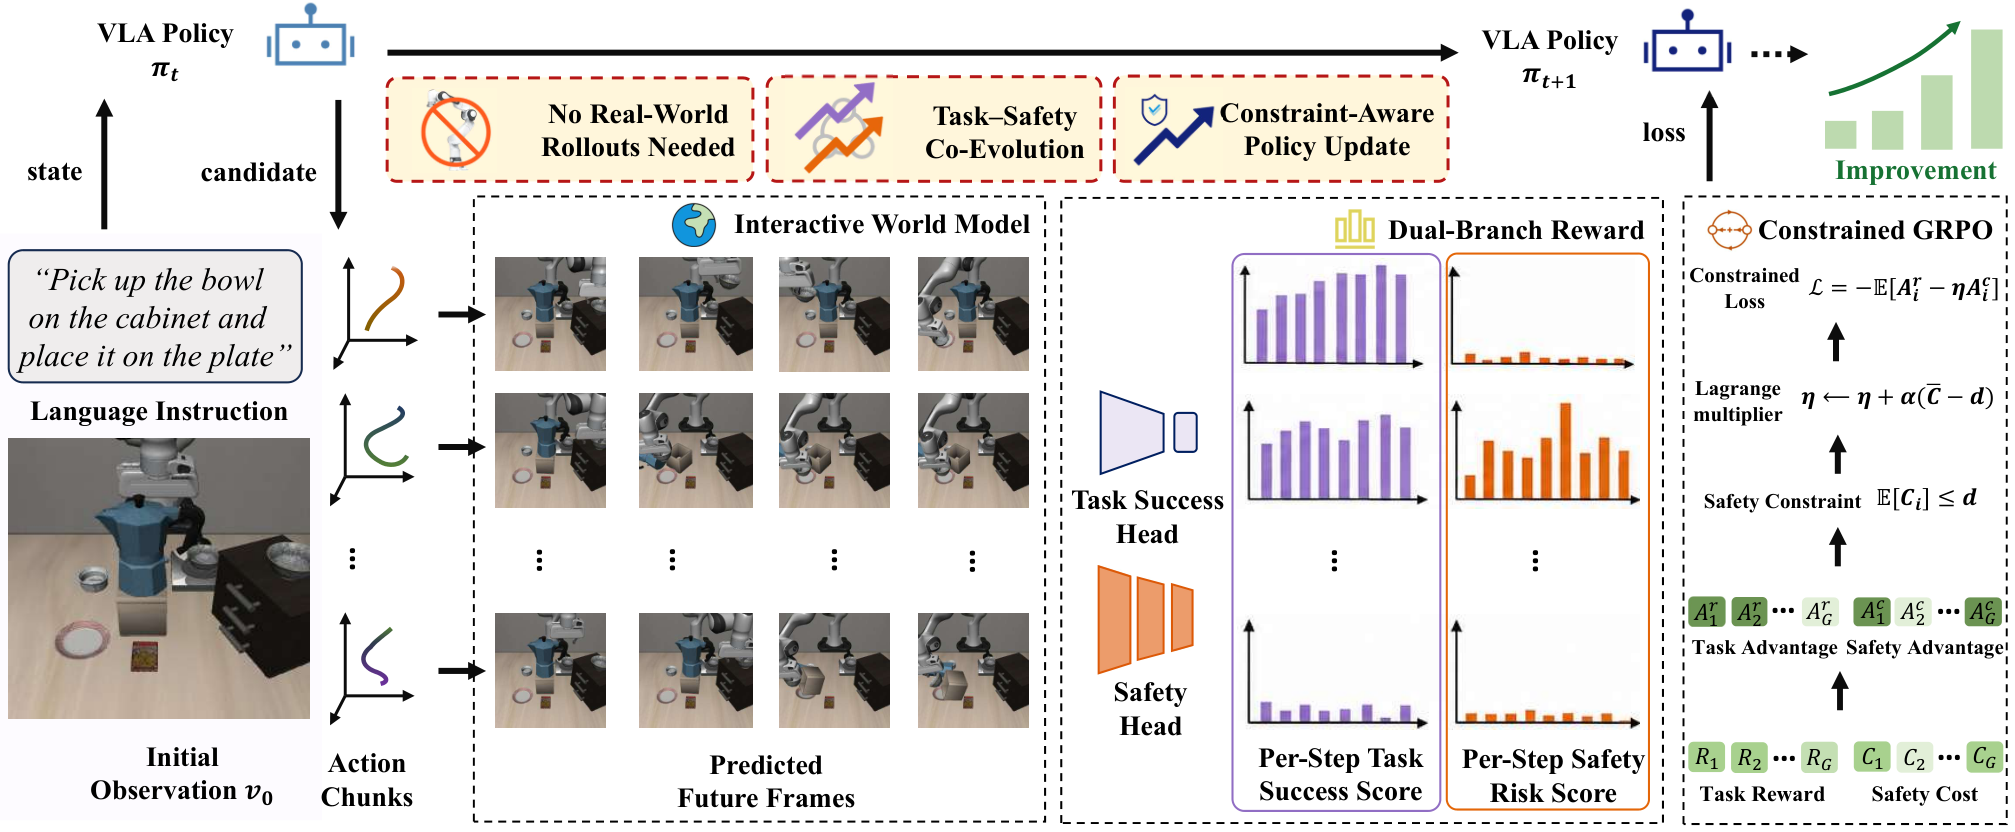
  5. SafeDojo 将动作条件世界模型轨迹、任务成功与安全评测,以及受约束的 GRPO 策略更新相结合。 CoRL 2026

    SafeDojo: Safe Reinforcement Learning for VLA via Interactive World Model

    Kai Tang, Peidong Jia, Zhong Chu, Jixian Wu, Rui Ma, Jiajun Cao, Fangyuan Zhao, Sixiang Chen, Yichen Guo, Xiaowei Chi, Chun-Kai Fan, Kevin Zhang, Jinchang Xu, Fubing Yang, Weishi Mi, Xiaozhu Ju, Jian Tang, Shanghang Zhang

    CoRL 2026 · 已录用 · 共同作者

    通过交互式世界模型中的想象轨迹开展 VLA 策略的安全强化学习,兼顾任务进展与安全性。

  6. SeeMe: Mitigating Hallucinations in Large Vision-Language Models through Effective Visual Token Engineering

    J. You*, K. Tang*, Yichen Guo, C. Li, H. Li, Y. Qu, X. Huang

    稿件 · 2026 · 共同作者

    通过视觉 token 工程提升一致性,缓解视觉语言模型中的幻觉。

  7. MAP: Mitigating Hallucinations in Large Vision-Language Models with Map-Level Attention Processing

    C. Li*, Yichen Guo*, B. Qian, J. You, K. Tang, Y. Du, Z. Zhang, X. Huang

    稿件 · 2026 · 同等贡献

    通过语义图层面的注意力处理,在无需训练的解码过程中缓解视觉语言模型幻觉。

  8. STAR: Stage-Wise Attention-Guided Token Reduction for Efficient Large Vision-Language Models Inference

    Yichen Guo, H. Li, Z. Zhang, J. You, K. Tang, X. Huang

    稿件 · 2025 · 第一作者

    STAR 的早期稿件,研究两阶段、无需训练的视觉 token 压缩;当前预印本为 STAR-Pro。

  9. Mitigating Hallucinations via Inter-Layer Consistency Aggregation in Large Vision-Language Models

    K. Tang*, J. You*, X. Ge, H. Li, Yichen Guo, X. Huang

    稿件 · 2025 · 共同作者

    在无需训练的解码过程中聚合层间表征,改善语义一致性并缓解幻觉。

基于 Jekyll 与 Minimal Light 主题构建。

研究图示

滚动查看完整图片,按 Esc 键关闭。