arXiv 2026 · 审稿中
RegimeVGGT
面向视觉几何 Transformer 的逐层空间保持冗余消除
郭奕辰 · 共同作者
Yichen Guo 研究主页内的项目介绍,依据下方链接中的论文整理。
项目概述
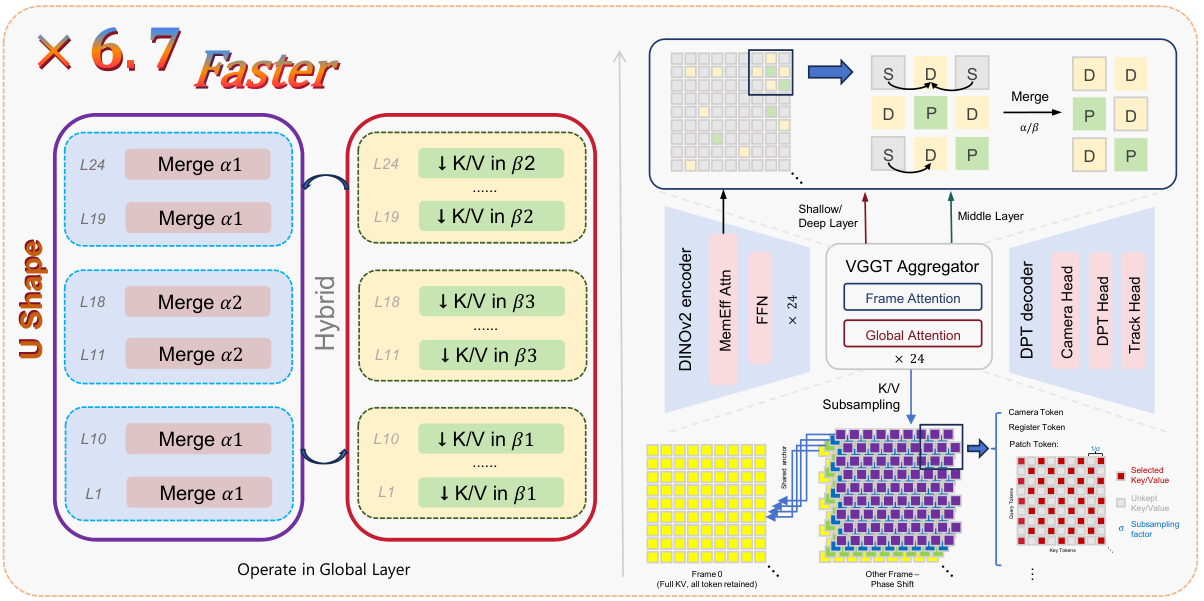
RegimeVGGT 无需额外训练即可加速视觉几何 Transformer。它结合随层变化的 token 合并与保留空间结构的 key/value 下采样,在减少冗余计算的同时,保护跨视角几何信息与相机位姿估计所需的信息。
方法流程
识别不同层承担的作用
逐层分析区分浅层、中层和深层的不同特征,由此采用 U 形压缩调度,而不是对所有层施加相同压缩程度。
合并 token 并保护空间细节
显著性引导的分段合并,在减少视觉 token 数量时保留与几何和边缘相关的重要 token。
选择性下采样 key 与 value
相位偏移的空间网格减少注意力计算;完整分辨率的参考帧,以及受保护的相机与 register token,维持跨帧空间覆盖和位姿信息路径。
评测
论文考察重建质量、相机位姿估计与运行时间,包含长图像序列设置。对比与消融实验分析了减少计算时必须保留的信息;具体设置和结果见原论文。
论文与资源
RegimeVGGT: Layer-Wise Spatially Preserving Redundancy Removal for Visual Geometry Grounded Transformer
arXiv:2606.18439
图示与技术介绍依据所链接的论文整理,原作者列表和发表状态见页首。