CoRL 2026 · 已录用
SafeDojo
通过交互式世界模型开展 VLA 安全强化学习
郭奕辰 · 共同作者
Yichen Guo 研究主页内的项目介绍,依据下方链接中的论文整理。
项目概述
SafeDojo 研究如何让视觉语言动作策略通过探索想象中的未来,学习更安全的机器人行为。交互式世界模型同时提供任务进展与碰撞风险的反馈,使策略优化能够分别考虑这两个目标。
方法流程
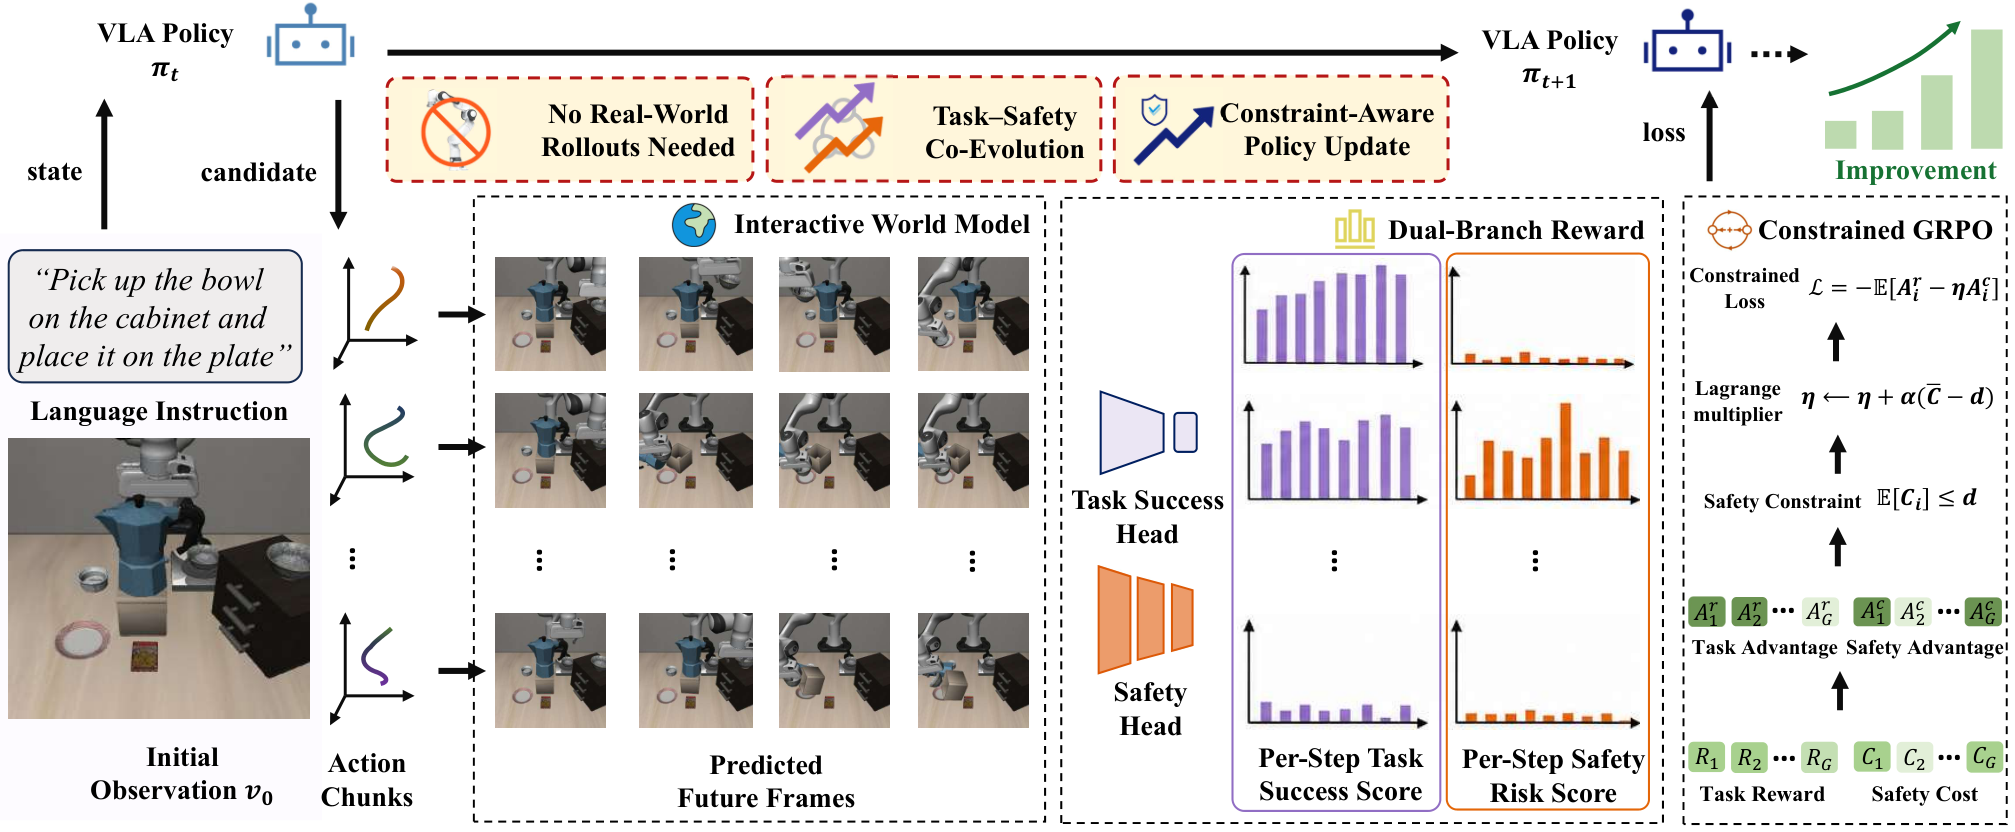
生成动作条件的想象轨迹
VLA 策略提出动作块,交互式视频世界模型据此向前预测视觉观测与隐空间动态。
分别评估任务进展与安全性
任务成功分类器对想象帧评分;安全预测头结合隐空间上下文与候选动作,估计碰撞代价。
在安全约束下更新策略
基于拉格朗日方法的受约束 GRPO 综合奖励与代价反馈,在控制安全风险的同时提高任务完成能力。
评测
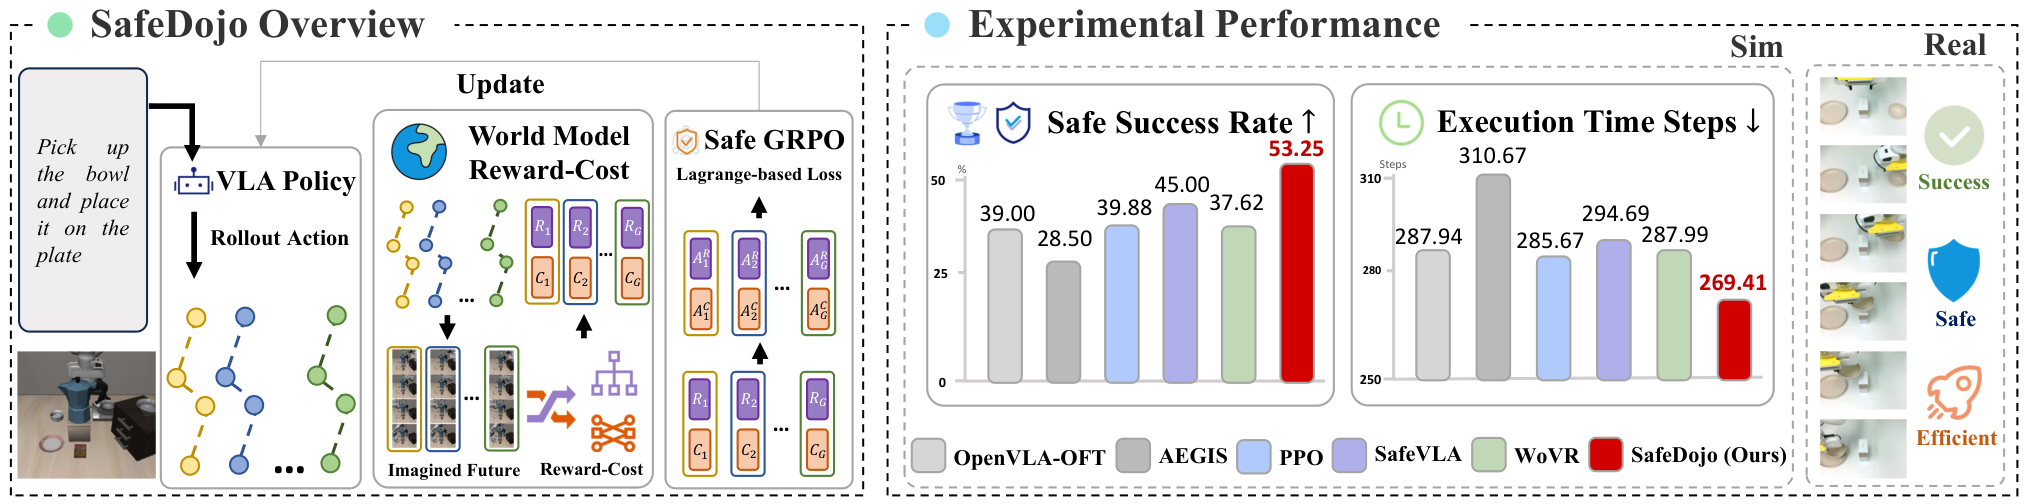
论文在包含两种障碍设置的 SafeLIBERO 上评估任务完成、无碰撞完成和执行效率,并通过五项真实 Franka 任务验证迁移效果。完整实验协议、对比与局限见原论文。
论文与资源
SafeDojo: Safe Reinforcement Learning for VLA via Interactive World Model
arXiv:2606.20698
图示与技术介绍依据所链接的论文整理,原作者列表和发表状态见页首。