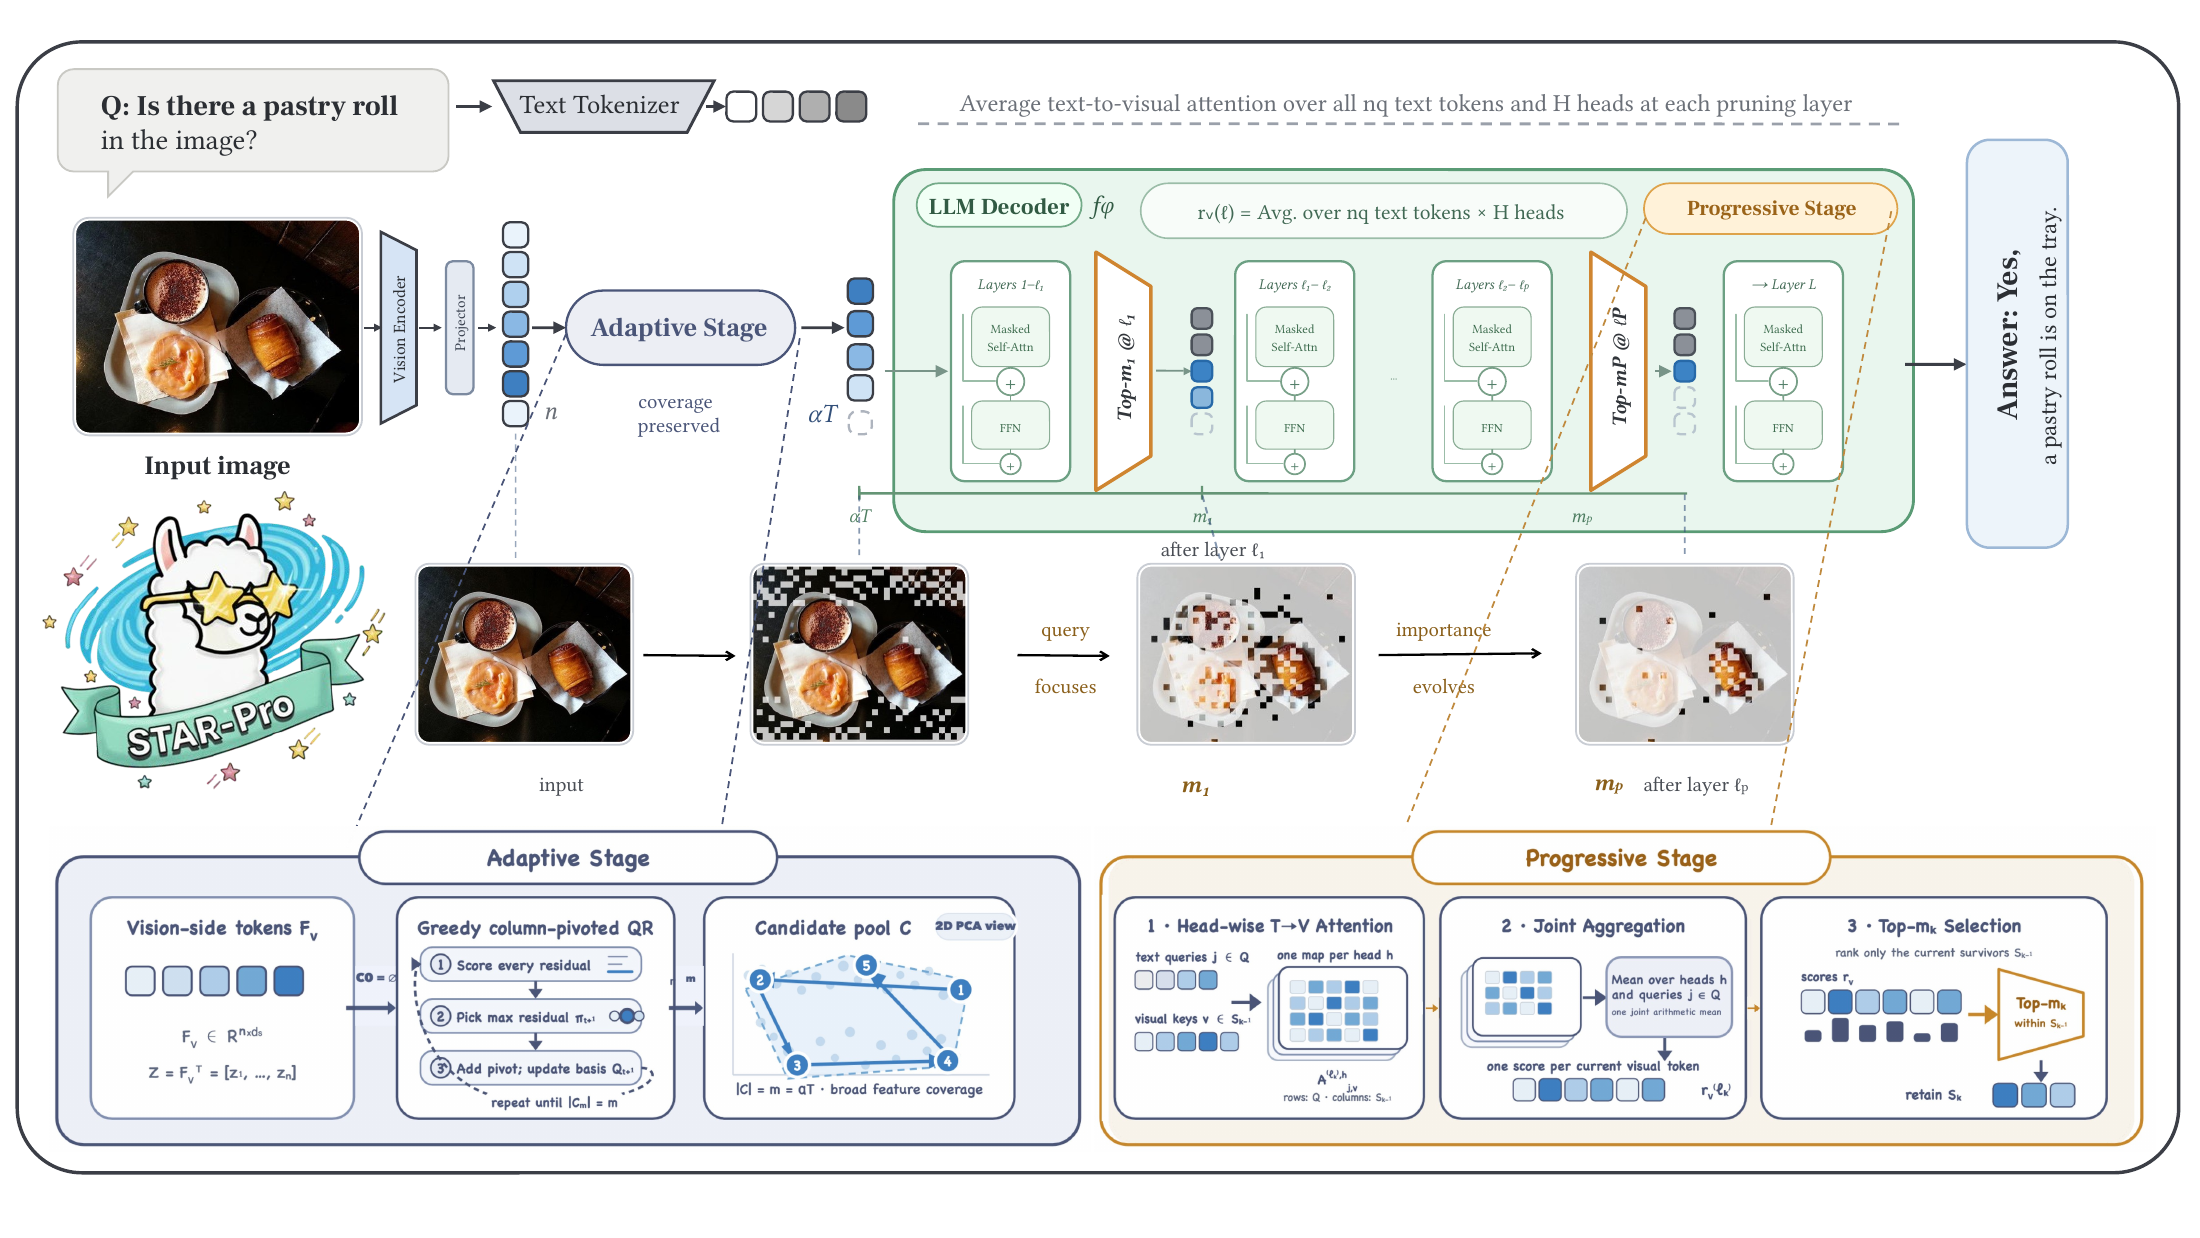
无需训练的视觉 token 压缩:先保留特征覆盖度,再随语言与视觉交互逐步细化保留的 token。
共同第一作者
作为共同第一作者,我参与了从自适应选择到渐进剪枝的方法设计,以及跨视觉语言模型架构的评测。
无需训练的视觉 token 压缩:先保留特征覆盖度,再随语言与视觉交互逐步细化保留的 token。
共同第一作者
作为共同第一作者,我参与了从自适应选择到渐进剪枝的方法设计,以及跨视觉语言模型架构的评测。
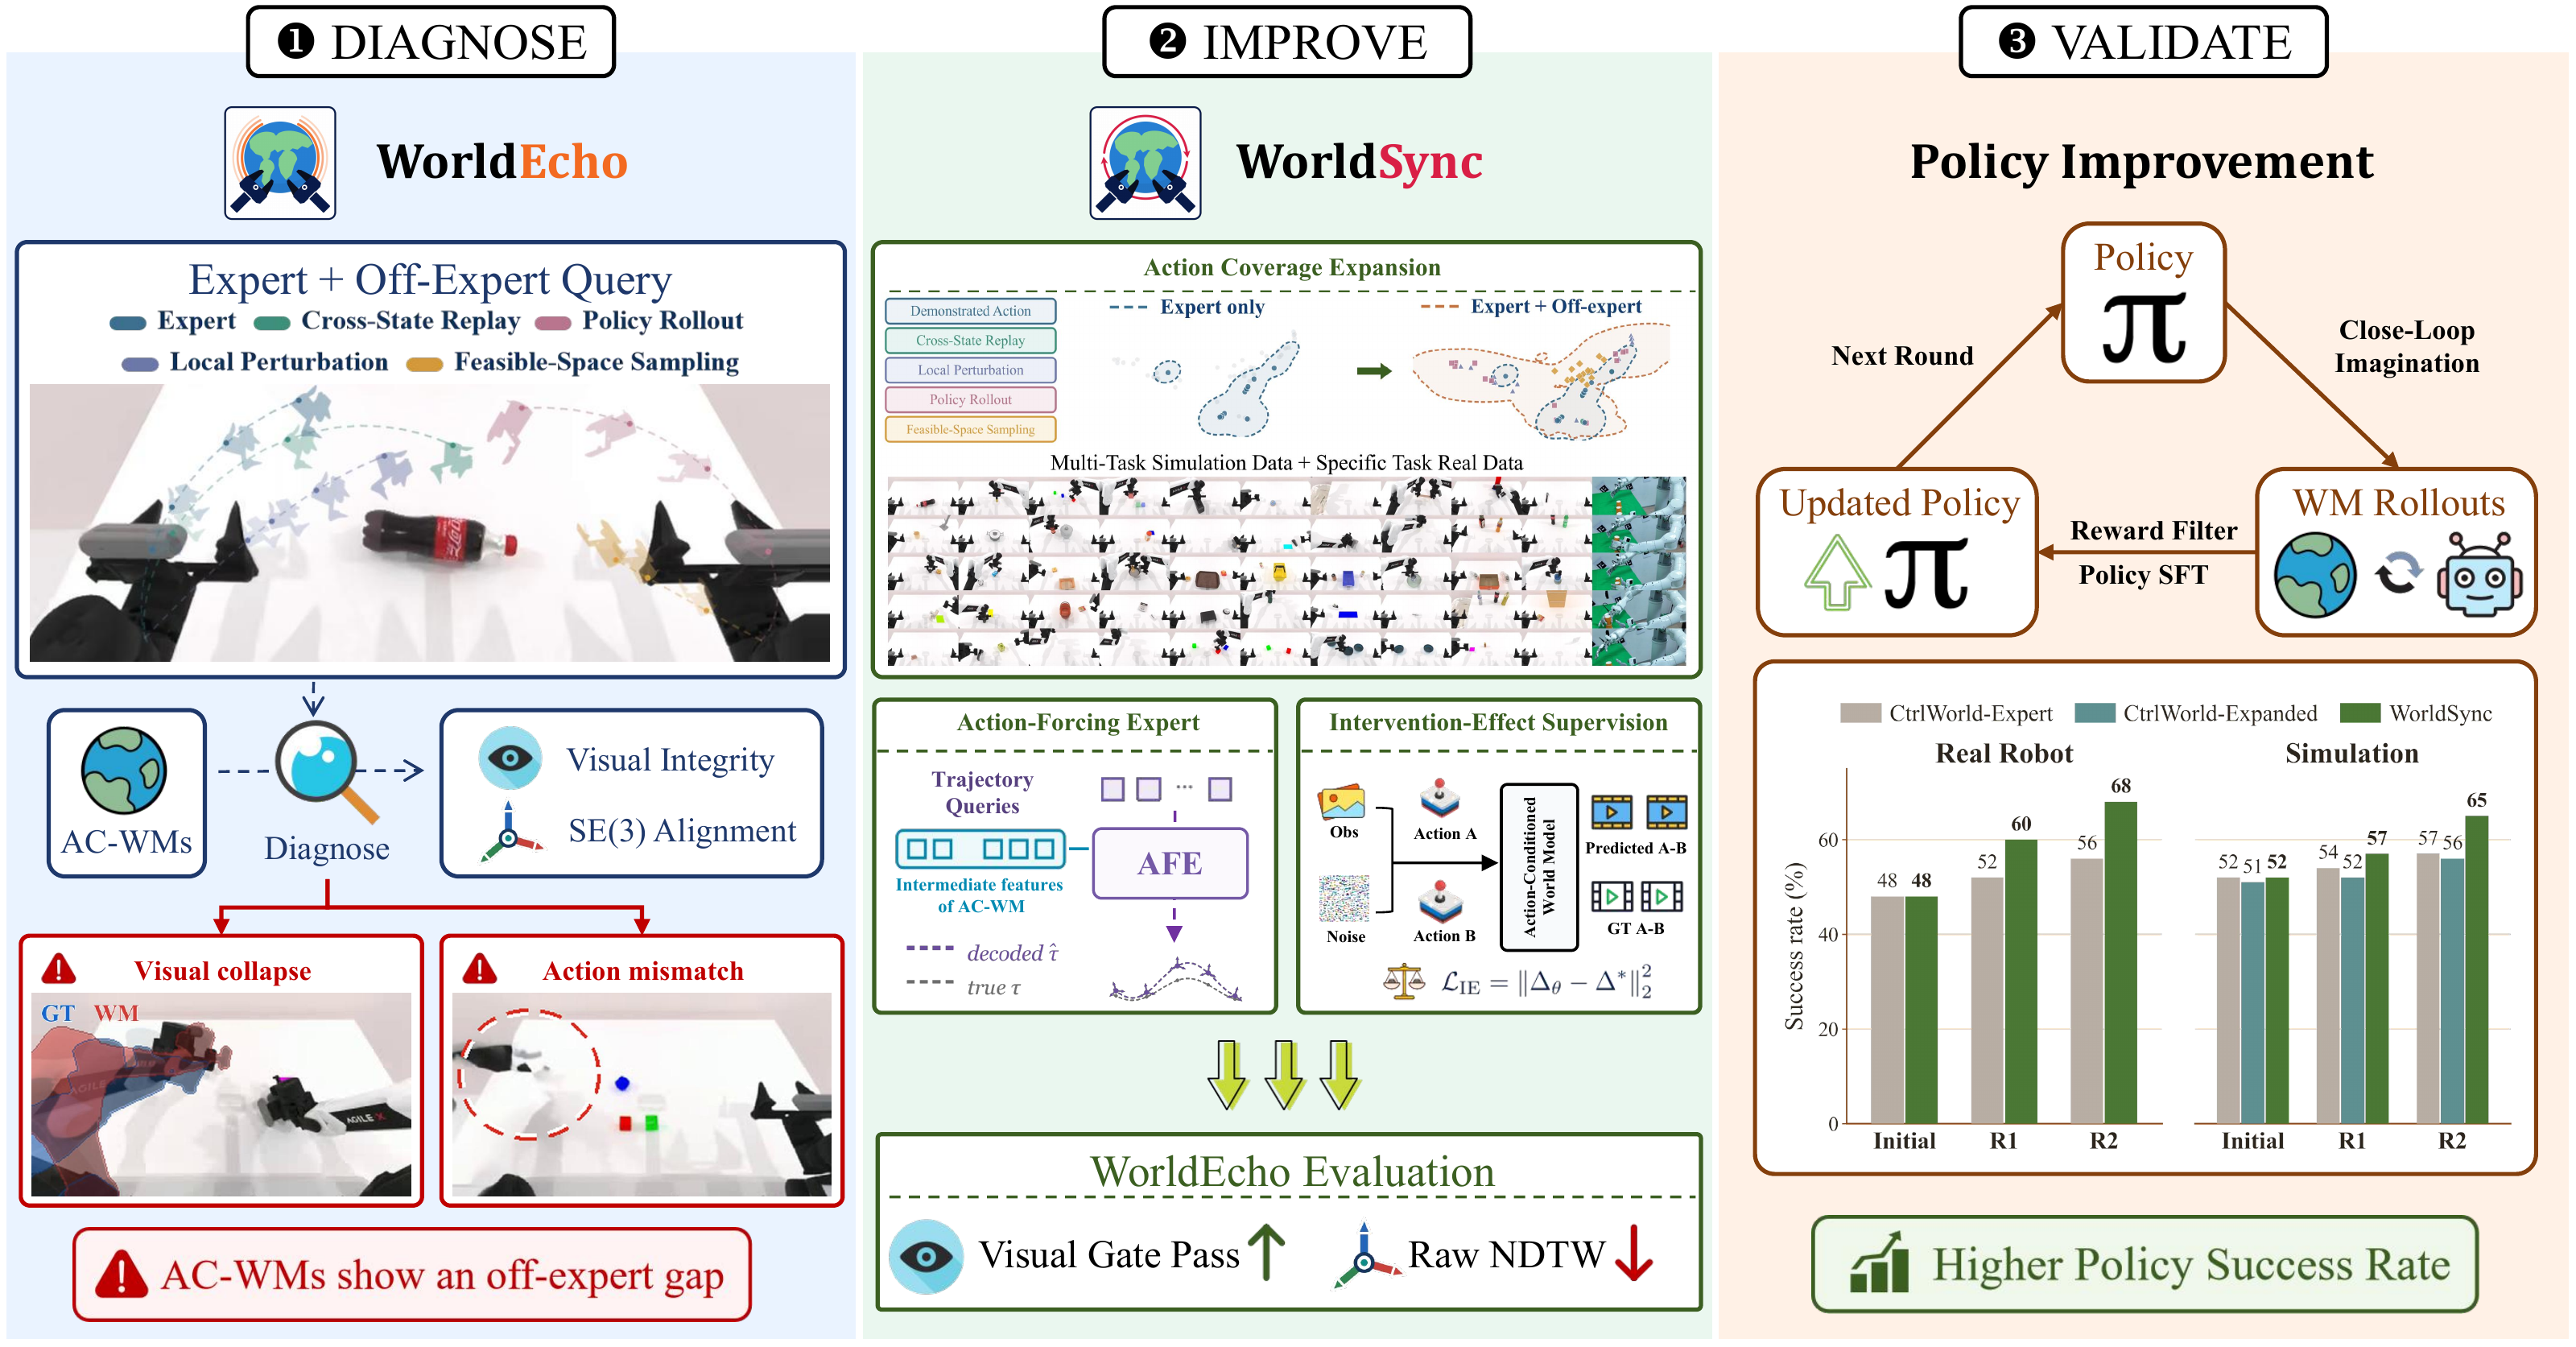
WorldEcho 诊断动作遵循失败;WorldSync 将生成过程与机器人动力学对齐,以支持策略学习。
核心贡献者
作为核心贡献者,我参与理解并改善机器人世界模型的动作遵循能力。
数据集目前限制访问,数据尚待上传。
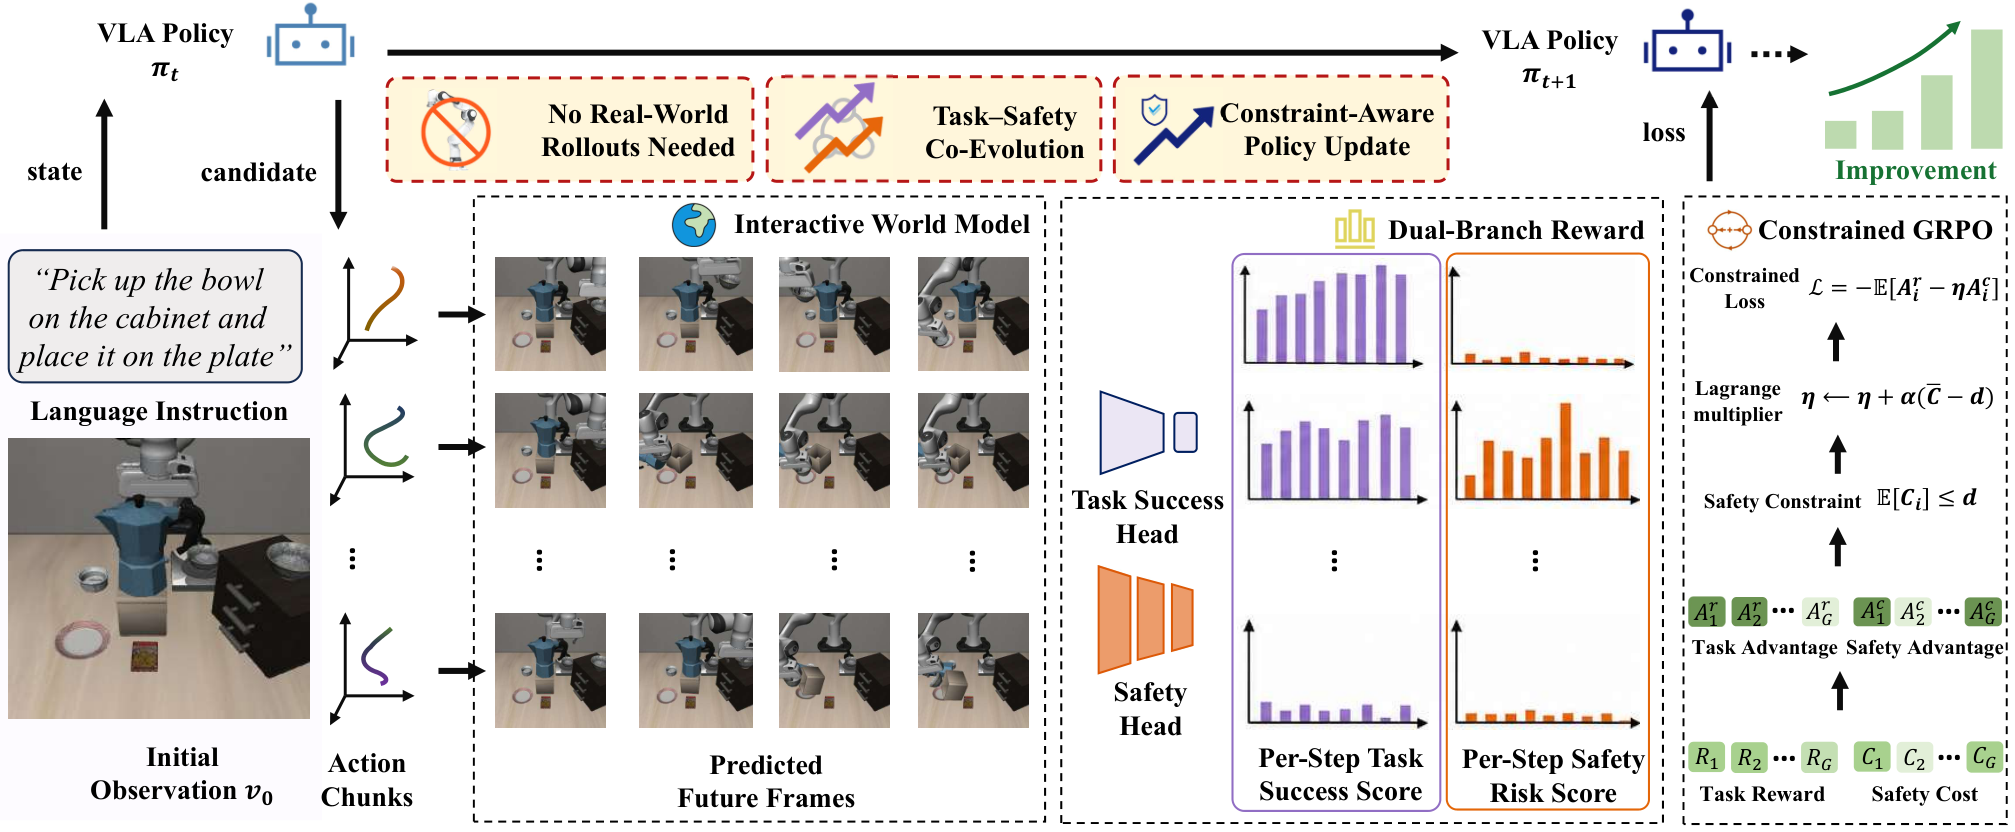
通过交互式世界模型中的想象轨迹开展 VLA 策略的安全强化学习,兼顾任务进展与安全性。
共同作者
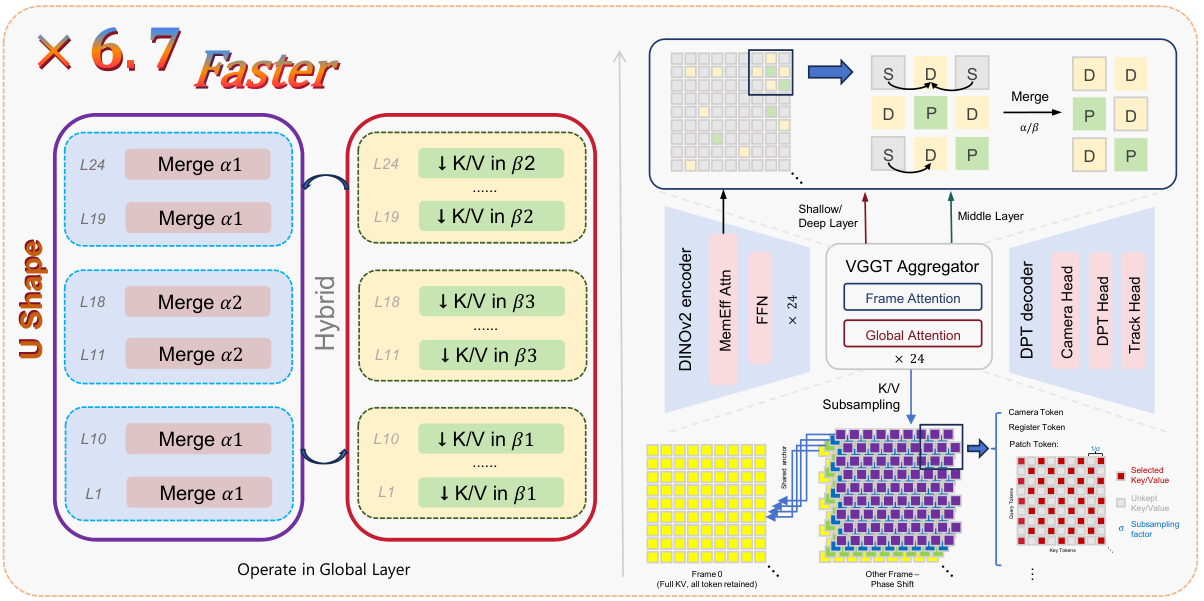
通过逐层 token 合并与保留空间结构的 K/V 下采样,无需训练地加速视觉几何 Transformer。
共同作者
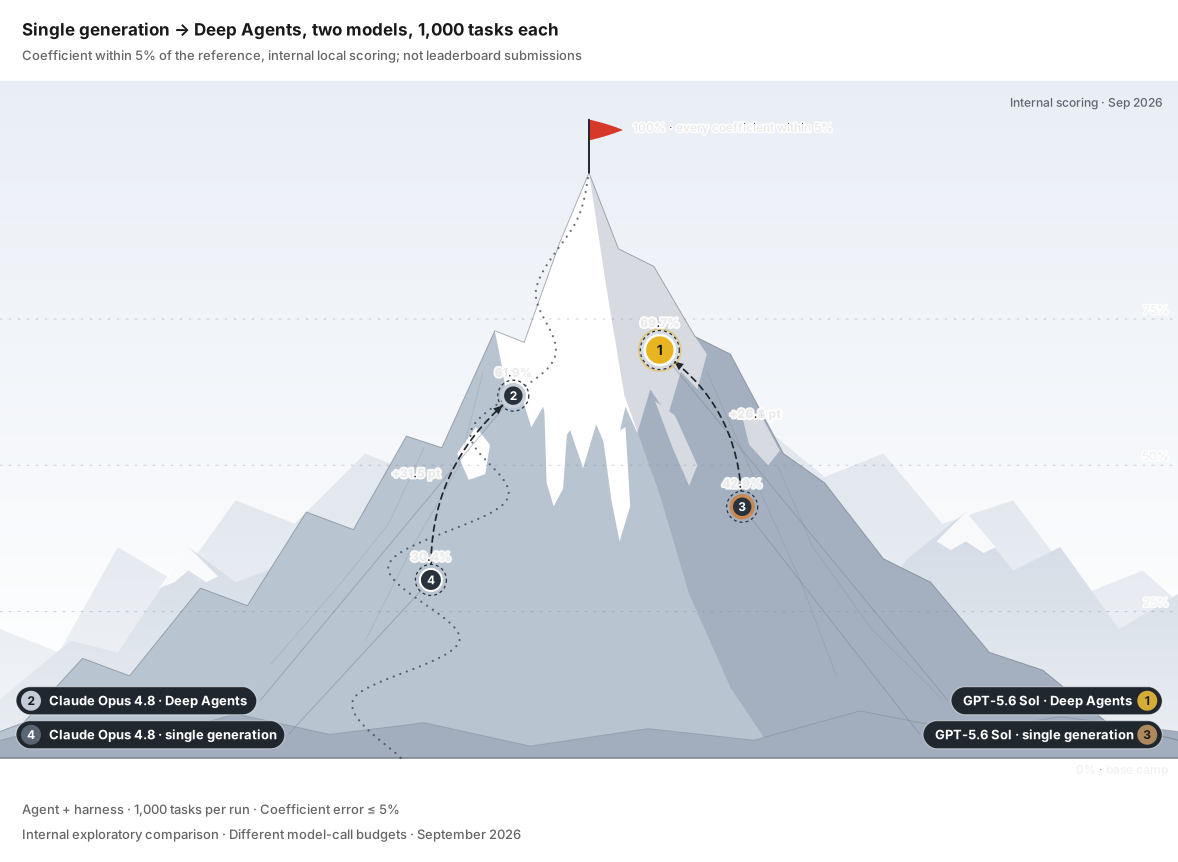
AI 智能体能否从实证研究问题与数据出发,得到可复现的统计结果?
评测流程、智能体运行框架集成与可复现性审计。
Agent + harness 登峰榜 · 2026 年 9 月。每组 1,000 项任务的内部探索性比较,模型调用预算不同。
基于 Jekyll 与 Minimal Light 主题构建。
 Hugging Face