arXiv 2026 · 预印本
MiCo
通过语义擦除建模进行互信息覆盖优化,实现高效多模态大语言模型推理
郭奕辰 · 共同第一作者
Yichen Guo 研究主页内的项目介绍,依据下方链接中的论文整理。
项目概述
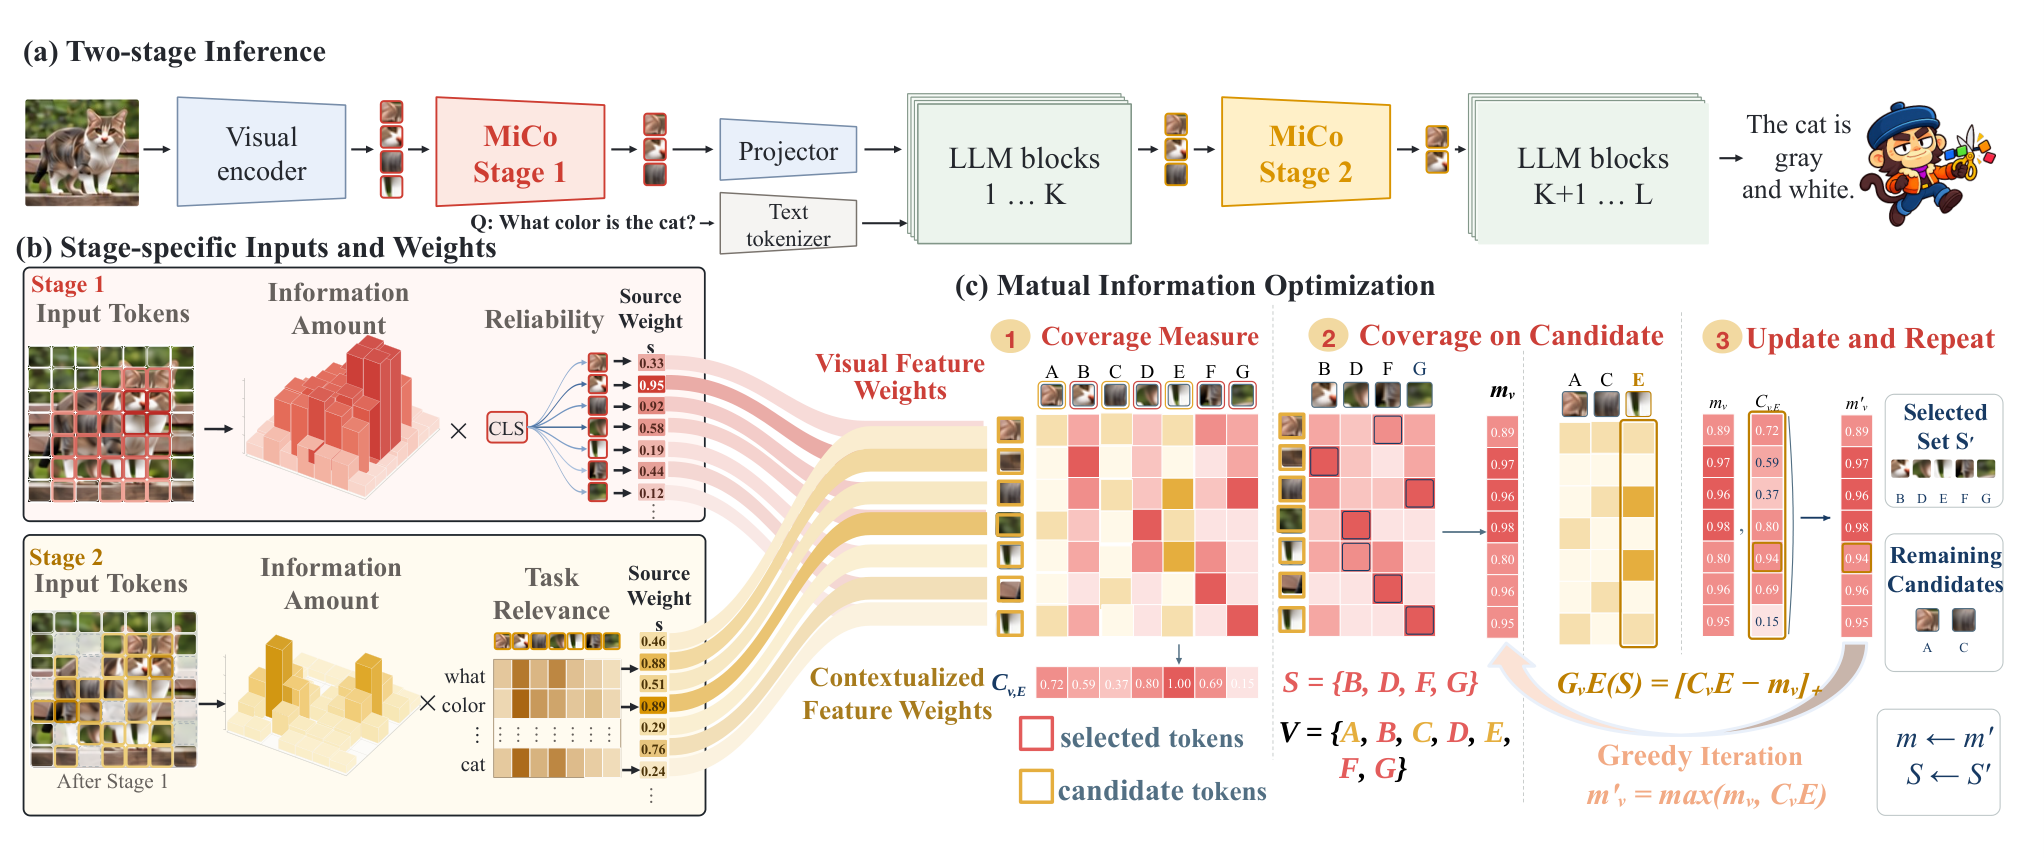
MiCo 无需额外训练即可降低多模态大语言模型的推理成本。它通过语义擦除模型,从任务对数损失推导互信息覆盖目标。方法选择能够覆盖有用视觉信息的 token 子集:先依据视觉特征建立候选池,再在语言模型内部结合任务相关信号进行细化。
方法流程
建立有代表性的视觉候选池
视觉 token 进入语言模型之前,第一阶段结合视觉特征范数与视觉编码器的 CLS 注意力,保留较大的候选池,在尚未与问题交互时维持视觉信息覆盖。
依据当前任务细化子集
在选定的解码器层,第二阶段结合上下文化的特征范数与文本到视觉的注意力,进一步选择覆盖当前问题相关信息的较小子集。
贪心优化加权覆盖目标
两个阶段均使用非负余弦相似度,衡量保留 token 对各源位置的代表程度;按边际加权覆盖增益逐个加入 token,直到达到预算。该可观测覆盖目标具有单调性与次模性,在基数约束下,贪心选择具有 1 − 1/e 的近似保证。
评测
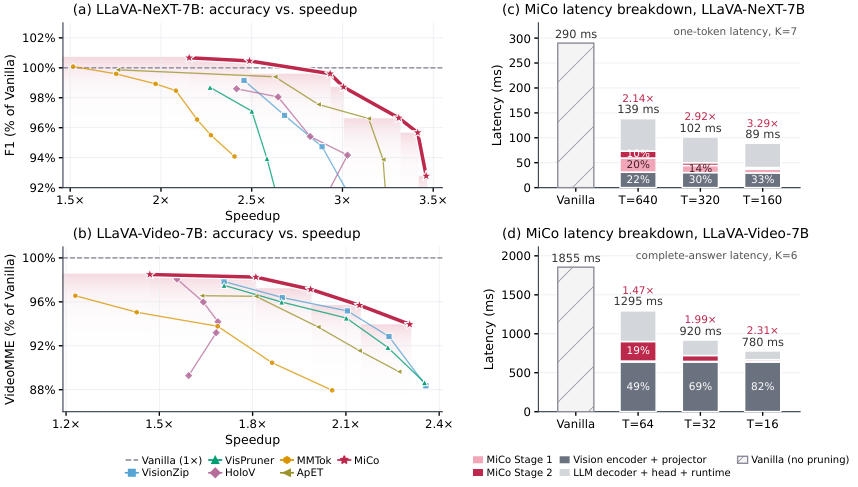
论文在八个图像模型与一个视频模型上评测视觉推理、OCR、定位、幻觉检测和长视频理解。在 LLaVA-NeXT-13B 上,论文报告仅保留 5.6% 的视觉 token,维持平均基线性能的 97.5%,单 token 推理加速约 3.8 倍。NeXT 计时使用单张 A800 80GB、batch size 1,不包含模型加载、预处理与主机到设备的数据传输。在 LLaVA-Video-7B 每帧保留 16 个 token 时,MiCo 维持平均基线性能的 93.0%,完整回答生成加速 2.31 倍。完整基准结果、消融实验与局限见原论文。
论文与资源
MiCo: Mutual Information Coverage Optimization through Semantic Erasure Modeling for Efficient MLLM Inference
arXiv:2609.34330
图示与技术介绍依据所链接的论文整理,原作者列表和发表状态见页首。